TF-IDF · 3 балла
TF-IDF: отличительные слова важнее общих
Частое во всех статьях слово мало помогает различать статьи. Редкое слово в конкретной статье полезнее.
- TF
- Доля токена в документе.
- DF
- В скольких документах слово встречается хотя бы раз.
- IDF
- Обратная частота документа, повышает вес редких слов.
- L2-норма
- Длина вектора: корень из суммы квадратов.
- Нормализация
- Деление вектора на его длину, после этого длина равна 1.
Сначала смысл, потом формула
Два документа: cat cat dog и cat bird. N=2, cat есть в обоих: df=2, IDF=1. Dog есть в одном: df=1, IDF=ln(3/2)+1=1.4055. У первого текста TF(cat)=2/3, TF(dog)=1/3. До нормализации веса: cat=0.6667, dog=0.4685. После L2: cat≈0.8182, dog≈0.5749.
TF-IDF = TF × IDF
Нормализация: v / sqrt(sum(v²))
TF фиксирован: 2 упоминания из 10 токенов, TF=0.2. Показан вес до L2.
Почему сравнение со sklearn точное
Я сначала делю счётчики на длину документа, потом умножаю на IDF и нормализую L2. Sklearn умножает сырые счётчики на IDF и нормализует. Общий множитель 1/длина сокращается при L2, поэтому результаты совпадают. Проверка: максимальная разница меньше 10⁻¹².
Слово стало встречаться в большем числе документов. Его IDF...
Знаменатель df+1 растёт, отношение уменьшается, логарифм тоже.
Код и построчный разбор
Код исходной ячейки 30: class TFIDF(BagOfWords):
class TFIDF(BagOfWords):
    def fit(self, documents):
        super().fit(documents)
        counts = super().transform(documents)
        document_frequency = np.asarray((counts > 0).sum(axis=0)).ravel()
        self.idf = np.log((1 + len(documents))/(1 + document_frequency)) + 1
        return self

    def transform(self, documents):
        counts = super().transform(documents)
        # TF: делим на число всех токенов документа, в том числе вне словаря.
        lengths = np.array([len(self.tokenize(text)) for text in documents], dtype=float)
        tf = counts.multiply((1/np.maximum(lengths, 1))[:, None]).tocsr()
        weighted = tf.multiply(self.idf).tocsr()
        # L2-нормализация убирает влияние длины; как в sklearn по умолчанию.
        norms = np.sqrt(np.asarray(weighted.multiply(weighted).sum(axis=1)).ravel())
        return weighted.multiply((1/np.maximum(norms, 1e-15))[:, None]).tocsr()
1: class TFIDF(BagOfWords):
Объявляет класс, который хранит настройки, словарь и методы преобразования.2: def fit(self, documents):
Объявляет функцию: код внутри выполняется при её вызове.3: super().fit(documents)
Обучает объект по переданным данным; test здесь использовать нельзя.4: counts = super().transform(documents)
Применяет уже выученную статистику, не добавляя слов из test.5: document_frequency = np.asarray((counts > 0).sum(axis=0)).ravel()
Превращает результат вычисления в массив NumPy; ravel делает его одномерным.6: self.idf = np.log((1 + len(documents))/(1 + document_frequency)) + 1
Вычисляет натуральный логарифм отношения; используется в IDF или контрасте частот.7: return self
Возвращает результат функции вызывающему коду.9: def transform(self, documents):
Объявляет функцию: код внутри выполняется при её вызове.10: counts = super().transform(documents)
Применяет уже выученную статистику, не добавляя слов из test.11: # TF: делим на число всех токенов документа, в том числе вне словаря.
Комментарий объясняет причину следующего действия.12: lengths = np.array([len(self.tokenize(text)) for text in documents], dtype=float)
Повторяет вложенный блок для каждого элемента указанной последовательности.13: tf = counts.multiply((1/np.maximum(lengths, 1))[:, None]).tocsr()
Выполняет поэлементное умножение разреженной матрицы, а не матричное @.14: weighted = tf.multiply(self.idf).tocsr()
Выполняет поэлементное умножение разреженной матрицы, а не матричное @.15: # L2-нормализация убирает влияние длины; как в sklearn по умолчанию.
Комментарий объясняет причину следующего действия.16: norms = np.sqrt(np.asarray(weighted.multiply(weighted).sum(axis=1)).ravel())
Выполняет поэлементное умножение разреженной матрицы, а не матричное @.17: return weighted.multiply((1/np.maximum(norms, 1e-15))[:, None]).tocsr()
Возвращает результат функции вызывающему коду.
Код исходной ячейки 31: tfidf = TFIDF(ngram_range=(1, 2), max_features=15)
tfidf = TFIDF(ngram_range=(1, 2), max_features=15)
test_sentences = [
    "tf-idf measures word importance relative to its frequency in a document",
    "tf-idf considers word uniqueness across all documents in the corpus",
    "it identifies significant words common in a document yet rare across all documents"
]
vectors = tfidf.fit_transform(test_sentences)
display(pd.DataFrame(vectors.toarray(), columns=list(tfidf.vocabulary)))
manual = TFIDF().fit(['cat cat dog', 'cat bird'])
np.testing.assert_allclose(manual.idf, [np.log(3/2)+1, 1, np.log(3/2)+1])
expected = np.array([0, 2, np.log(3/2)+1]); expected /= np.linalg.norm(expected)
np.testing.assert_allclose(manual.transform(['cat cat dog']).toarray()[0], expected)
print('IDF и TF-IDF проверены вручную')
1: tfidf = TFIDF(ngram_range=(1, 2), max_features=15)
Вычисляет правую часть и сохраняет результат в tfidf.2: test_sentences = [
Вычисляет правую часть и сохраняет результат в test_sentences.3: "tf-idf measures word importance relative to its frequency in a document",
Продолжает выражение предыдущей строки: здесь заданы данные или аргументы вызова.4: "tf-idf considers word uniqueness across all documents in the corpus",
Продолжает выражение предыдущей строки: здесь заданы данные или аргументы вызова.5: "it identifies significant words common in a document yet rare across all documents"
Продолжает выражение предыдущей строки: здесь заданы данные или аргументы вызова.6: ]
Завершает многострочное выражение или набор настроек.7: vectors = tfidf.fit_transform(test_sentences)
Выучивает словарь и статистику по обучающим текстам и сразу строит их матрицу.8: display(pd.DataFrame(vectors.toarray(), columns=list(tfidf.vocabulary)))
Разворачивает маленький пример в плотную таблицу; большой корпус так не храним.9: manual = TFIDF().fit(['cat cat dog', 'cat bird'])
Обучает объект по переданным данным; test здесь использовать нельзя.10: np.testing.assert_allclose(manual.idf, [np.log(3/2)+1, 1, np.log(3/2)+1])
Вычисляет натуральный логарифм отношения; используется в IDF или контрасте частот.11: expected = np.array([0, 2, np.log(3/2)+1]); expected /= np.linalg.norm(expected)
Вычисляет натуральный логарифм отношения; используется в IDF или контрасте частот.12: np.testing.assert_allclose(manual.transform(['cat cat dog']).toarray()[0], expected)
Применяет уже выученную статистику, не добавляя слов из test.13: print('IDF и TF-IDF проверены вручную')
Печатает число или пояснение, чтобы проверить результат выполнения.
Код исходной ячейки 33: for ngrams, limit in [((1, 1), 5000), ((1, 1), 15000), ((1, 2), 15000)]:
for ngrams, limit in [((1, 1), 5000), ((1, 1), 15000), ((1, 2), 15000)]:
    evaluate(f'own TFIDF {ngrams} {limit}', TFIDF(ngrams, limit))
display(pd.DataFrame(results).round(4))
1: for ngrams, limit in [((1, 1), 5000), ((1, 1), 15000), ((1, 2), 15000)]:
Повторяет вложенный блок для каждого элемента указанной последовательности.2: evaluate(f'own TFIDF {ngrams} {limit}', TFIDF(ngrams, limit))
Продолжает выражение предыдущей строки: здесь заданы данные или аргументы вызова.3: display(pd.DataFrame(results).round(4))
Показывает таблицу в ноутбуке.
Код исходной ячейки 35: own_tf = TFIDF((1, 2), 15000).fit(train_text)
own_tf = TFIDF((1, 2), 15000).fit(train_text)
sk_tf = TfidfVectorizer(vocabulary=own_tf.vocabulary, ngram_range=(1, 2)).fit(train_text)
for texts in [train_text, test_text, pd.Series(['', 'unknownwordxyz'])]:
    delta = own_tf.transform(texts) - sk_tf.transform(texts)
    assert np.max(np.abs(delta.data), initial=0) < 1e-12
print('TF-IDF совпадает со sklearn с точностью 1e-12')
evaluate('sklearn TFIDF fixed vocabulary', sk_tf)

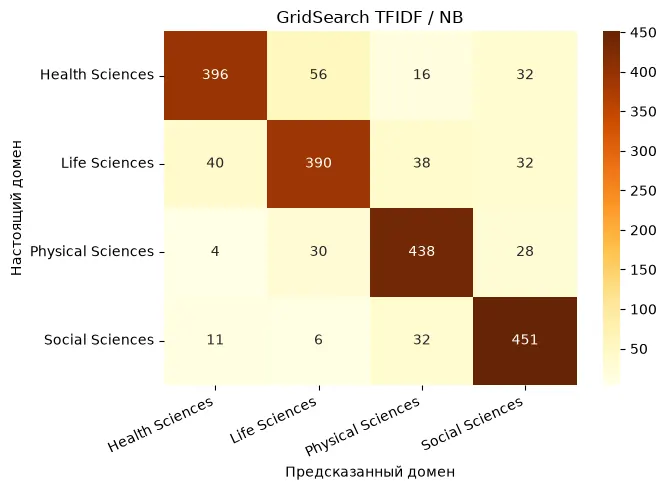
for (kind, title), search in searches.items():
    pred = search.predict(test_text)
    print(kind, title, 'CV:', round(search.best_score_,4), 'test macro-F1:', round(f1_score(y_test,pred,average='macro'),4))
    print(classification_report(y_test, pred, digits=3, zero_division=0))
    plt.figure(figsize=(7,5))
    sns.heatmap(confusion_matrix(y_test,pred,labels=labels),annot=True,fmt='d',xticklabels=labels,yticklabels=labels,cmap='YlOrBr')
    plt.xlabel('Предсказанный домен');plt.ylabel('Настоящий домен');plt.title(f'GridSearch {kind} / {title}')
    plt.xticks(rotation=25,ha='right');plt.yticks(rotation=0);plt.tight_layout();plt.show()
1: own_tf = TFIDF((1, 2), 15000).fit(train_text)
Обучает объект по переданным данным; test здесь использовать нельзя.2: sk_tf = TfidfVectorizer(vocabulary=own_tf.vocabulary, ngram_range=(1, 2)).fit(train_text)
Обучает объект по переданным данным; test здесь использовать нельзя.3: for texts in [train_text, test_text, pd.Series(['', 'unknownwordxyz'])]:
Повторяет вложенный блок для каждого элемента указанной последовательности.4: delta = own_tf.transform(texts) - sk_tf.transform(texts)
Применяет уже выученную статистику, не добавляя слов из test.5: assert np.max(np.abs(delta.data), initial=0) < 1e-12
Проверяет ожидаемое свойство; если оно нарушено, останавливает запуск.6: print('TF-IDF совпадает со sklearn с точностью 1e-12')
Печатает число или пояснение, чтобы проверить результат выполнения.7: evaluate('sklearn TFIDF fixed vocabulary', sk_tf)
Продолжает выражение предыдущей строки: здесь заданы данные или аргументы вызова.9: for (kind, title), search in searches.items():
Повторяет вложенный блок для каждого элемента указанной последовательности.10: pred = search.predict(test_text)
Получает предсказанные домены из обученного классификатора.11: print(kind, title, 'CV:', round(search.best_score_,4), 'test macro-F1:', round(f1_score(y_test,pred,average='macro'),4))
Печатает число или пояснение, чтобы проверить результат выполнения.12: print(classification_report(y_test, pred, digits=3, zero_division=0))
Выводит precision, recall, F1 и support отдельно по каждому классу.13: plt.figure(figsize=(7,5))
Настраивает график, подписи или выводит его на экран.14: sns.heatmap(confusion_matrix(y_test,pred,labels=labels),annot=True,fmt='d',xticklabels=labels,yticklabels=labels,cmap='YlOrBr')
Считает таблицу настоящих и предсказанных меток.15: plt.xlabel('Предсказанный домен');plt.ylabel('Настоящий домен');plt.title(f'GridSearch {kind} / {title}')
Настраивает график, подписи или выводит его на экран.16: plt.xticks(rotation=25,ha='right');plt.yticks(rotation=0);plt.tight_layout();plt.show()
Настраивает график, подписи или выводит его на экран.
Вопросы защиты
Зачем +1?
Сглаживание: нет деления на ноль, IDF при df=N равен 1.
max_features по IDF?
Нет. По условию словарь отбирается по суммарной частоте токенов, потом считаются IDF.
Нужно ли умножать TF и IDF циклом?
Нет. Используется поэлементное умножение разреженной матрицы на вектор IDF.
TF-IDF понимает смысл?
Он учитывает статистическую редкость, но не понимает синонимы сам по себе.