BoW · 3 балла
BoW: текст как счётчик слов
Выбираем словарь и считаем, сколько раз каждое слово встречается в статье.
- Корпус
- Все тексты, с которыми работаем.
- Словарь / vocabulary
- Слово → номер столбца.
- Вектор
- Список чисел для одного документа.
- Матрица
- Таблица: строка = документ, столбец = признак.
- N-грамма
- n соседних слов: machine learning это биграмма.
- max_features
- Максимальное число столбцов, отбираемых по частоте.
- CSR
- Разреженный формат: хранит ненулевые значения и их координаты.
- fit / transform
- Выучить словарь / посчитать векторы по готовому словарю.
Словарь учится по «cat cat dog» и «dog bird». Новый текст проходит только transform.
Как выглядит вектор
Словарь [bird, cat, dog], текст cat cat dog: [0,2,1]. Весь корпус из двух текстов: [[0,2,1],[1,0,1]]. Слово fish на test не создаёт новый столбец.
Что делает мой класс
- tokenize: выделяет слова длиной от 2 символов, собирает n-граммы.
- fit: Counter считает суммарную частоту в train.
- Сортировка: сначала частота по убыванию, при равенстве алфавит.
- Отбор max_features, затем фиксируем номера столбцов.
- transform: Counter для каждой статьи и заполнение CSR.
После fit в test встретилось fish, которого нет в словаре. Что делать?
Число и порядок столбцов должны быть теми же, что при обучении классификатора.
Код и построчный разбор
Код исходной ячейки 18: from collections import Counter
from collections import Counter
from scipy.sparse import csr_matrix

class BagOfWords:
    def __init__(self, ngram_range=(1, 1), max_features=None):
        self.ngram_range = ngram_range
        self.max_features = max_features
        self.vocabulary = {}

    def tokenize(self, text):
        words = re.findall(r'(?u)\b\w\w+\b', text.lower())
        return [' '.join(words[i:i+n]) for n in range(self.ngram_range[0], self.ngram_range[1]+1)
                for i in range(len(words)-n+1)]

    def fit(self, documents):
        counts = Counter(token for document in documents for token in self.tokenize(document))
        ranked = sorted(counts, key=lambda word: (-counts[word], word))
        selected = sorted(ranked[:self.max_features])
        self.vocabulary = {word: index for index, word in enumerate(selected)}
        if not selected:
            raise ValueError('Пустой словарь')
        return self

    def transform(self, documents):
        if not self.vocabulary:
            raise ValueError('Сначала вызовите fit')
        rows, columns, values = [], [], []
        for row, document in enumerate(documents):
            counts = Counter(self.tokenize(document))
            for word, count in counts.items():
                if word in self.vocabulary:
                    rows.append(row); columns.append(self.vocabulary[word]); values.append(count)
        return csr_matrix((values, (rows, columns)), shape=(len(documents), len(self.vocabulary)), dtype=np.float64)

    def fit_transform(self, documents):
        return self.fit(documents).transform(documents)
1: from collections import Counter
Подключает готовые инструменты; import сам по себе модель не обучает.2: from scipy.sparse import csr_matrix
Подключает готовые инструменты; import сам по себе модель не обучает.4: class BagOfWords:
Объявляет класс, который хранит настройки, словарь и методы преобразования.5: def __init__(self, ngram_range=(1, 1), max_features=None):
Объявляет функцию: код внутри выполняется при её вызове.6: self.ngram_range = ngram_range
Сохраняет настройку или промежуточный результат внутри объекта.7: self.max_features = max_features
Сохраняет настройку или промежуточный результат внутри объекта.8: self.vocabulary = {}
Фиксирует соответствие признака номеру столбца.10: def tokenize(self, text):
Объявляет функцию: код внутри выполняется при её вызове.11: words = re.findall(r'(?u)\b\w\w+\b', text.lower())
Вычисляет правую часть и сохраняет результат в words.12: return [' '.join(words[i:i+n]) for n in range(self.ngram_range[0], self.ngram_range[1]+1)
Возвращает результат функции вызывающему коду.13: for i in range(len(words)-n+1)]
Повторяет вложенный блок для каждого элемента указанной последовательности.15: def fit(self, documents):
Объявляет функцию: код внутри выполняется при её вызове.16: counts = Counter(token for document in documents for token in self.tokenize(document))
Повторяет вложенный блок для каждого элемента указанной последовательности.17: ranked = sorted(counts, key=lambda word: (-counts[word], word))
Сортирует значения, чтобы порядок слов и столбцов был воспроизводимым.18: selected = sorted(ranked[:self.max_features])
Сохраняет настройку или промежуточный результат внутри объекта.19: self.vocabulary = {word: index for index, word in enumerate(selected)}
Повторяет вложенный блок для каждого элемента указанной последовательности.20: if not selected:
Выполняет вложенный блок только при истинном условии.21: raise ValueError('Пустой словарь')
Сообщает об ошибке и останавливает этот путь выполнения.22: return self
Возвращает результат функции вызывающему коду.24: def transform(self, documents):
Объявляет функцию: код внутри выполняется при её вызове.25: if not self.vocabulary:
Выполняет вложенный блок только при истинном условии.26: raise ValueError('Сначала вызовите fit')
Сообщает об ошибке и останавливает этот путь выполнения.27: rows, columns, values = [], [], []
Вычисляет правую часть и сохраняет результат в rows, columns, values.28: for row, document in enumerate(documents):
Повторяет вложенный блок для каждого элемента указанной последовательности.29: counts = Counter(self.tokenize(document))
Подсчитывает частоты токенов или пар.30: for word, count in counts.items():
Повторяет вложенный блок для каждого элемента указанной последовательности.31: if word in self.vocabulary:
Выполняет вложенный блок только при истинном условии.32: rows.append(row); columns.append(self.vocabulary[word]); values.append(count)
Сохраняет настройку или промежуточный результат внутри объекта.33: return csr_matrix((values, (rows, columns)), shape=(len(documents), len(self.vocabulary)), dtype=np.float64)
Возвращает результат функции вызывающему коду.35: def fit_transform(self, documents):
Объявляет функцию: код внутри выполняется при её вызове.36: return self.fit(documents).transform(documents)
Возвращает результат функции вызывающему коду.
Код исходной ячейки 19: bow = BagOfWords(ngram_range=(1, 2), max_features=15)
bow = BagOfWords(ngram_range=(1, 2), max_features=15)
test_sentences = [
    "BoW transforms text into a frequency vector based on words occurrence",
    "in BoW each word's count creates a unique feature",
    "BoW ignores word order focusing on word occurrence frequency",
]
vectors = bow.fit_transform(test_sentences)
pd.DataFrame(vectors.toarray(), columns=list(bow.vocabulary))
1: bow = BagOfWords(ngram_range=(1, 2), max_features=15)
Вычисляет правую часть и сохраняет результат в bow.2: test_sentences = [
Вычисляет правую часть и сохраняет результат в test_sentences.3: "BoW transforms text into a frequency vector based on words occurrence",
Продолжает выражение предыдущей строки: здесь заданы данные или аргументы вызова.4: "in BoW each word's count creates a unique feature",
Продолжает выражение предыдущей строки: здесь заданы данные или аргументы вызова.5: "BoW ignores word order focusing on word occurrence frequency",
Продолжает выражение предыдущей строки: здесь заданы данные или аргументы вызова.6: ]
Завершает многострочное выражение или набор настроек.7: vectors = bow.fit_transform(test_sentences)
Выучивает словарь и статистику по обучающим текстам и сразу строит их матрицу.8: pd.DataFrame(vectors.toarray(), columns=list(bow.vocabulary))
Разворачивает маленький пример в плотную таблицу; большой корпус так не храним.
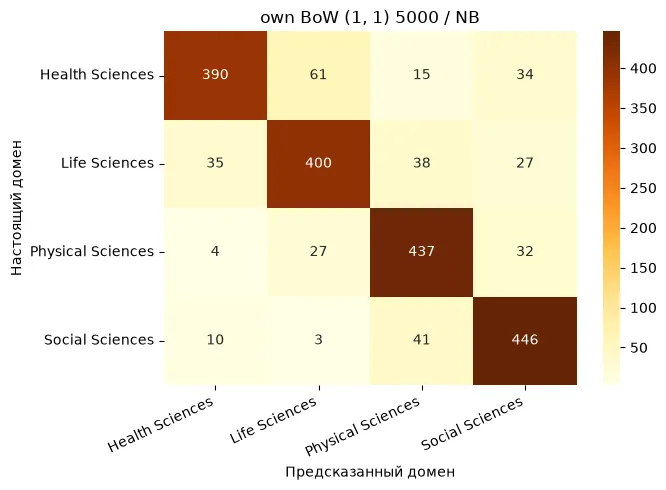
Код исходной ячейки 21: for ngrams, limit in [((1, 1), 5000), ((1, 1), 15000), ((1, 2), 15000)]:
for ngrams, limit in [((1, 1), 5000), ((1, 1), 15000), ((1, 2), 15000)]:
    evaluate(f'own BoW {ngrams} {limit}', BagOfWords(ngrams, limit))
display(pd.DataFrame(results).round(4))
1: for ngrams, limit in [((1, 1), 5000), ((1, 1), 15000), ((1, 2), 15000)]:
Повторяет вложенный блок для каждого элемента указанной последовательности.2: evaluate(f'own BoW {ngrams} {limit}', BagOfWords(ngrams, limit))
Продолжает выражение предыдущей строки: здесь заданы данные или аргументы вызова.3: display(pd.DataFrame(results).round(4))
Показывает таблицу в ноутбуке.
Вопросы защиты
Почему CSR?
8000 × 15000 float64 занимают около 960 МБ в плотном виде. Большинство элементов нули, их хранить незачем.
Что теряет BoW?
Порядок слов. Биграммы частично возвращают локальный порядок.
Как проверил со sklearn?
При одинаковом vocabulary сравнил каждую ячейку train- и test-матриц, число различий равно нулю.
Можно тут без цикла?
Подсчёт переменных строковых токенов естественно использует цикл. Это не MSE или градиент, которые нужно считать матрично.