Раздел GloVe · 3 балла вместе с SVD
GloVe: похожесть, смысл и предвзятость
Готовая модель знает 400000 слов. У каждого слова 200 чисел; статью представляем средним её слов.
- Косинусная близость
- Сходство направлений векторов: от -1 до 1.
- Косинусное расстояние
- 1 минус косинусная близость.
- OOV
- Слово отсутствует в словаре модели.
- Mean vector
- Средний вектор известных слов статьи.
- Bias
- Перекос ассоциаций, унаследованный от обучающих текстов.
distance = 1 - cos(a,b)
В most_similar считаю близости сразу ко всем словам, ставлю своему слову оценку минус бесконечность и выбираю top_n. Близость 1 означает одинаковое направление, а не обязательно одинаковое значение слова.
Один вектор направлен вправо. Поворачивай второй:
Три эксперимента
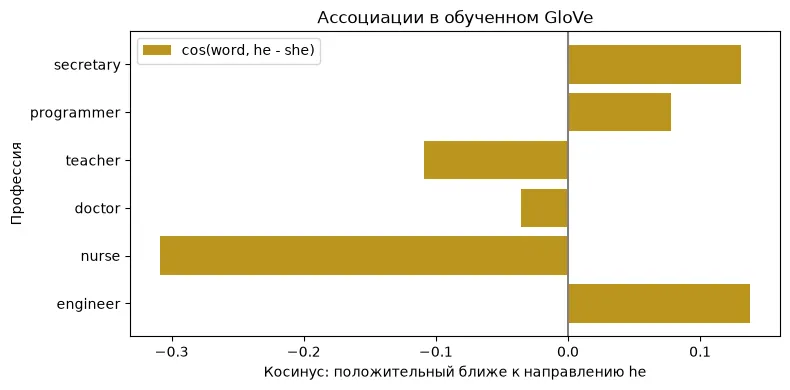
bank: у одного статического вектора смешиваются значения «банк» и «берег», часто доминирует более частое. Синоним / антоним: good и bad встречаются в похожих фразах, поэтому могут быть ближе, чем good и excellent. Профессии и пол: сравниваю профессии с направлением he - she; это ассоциации текстов, не факты о людях.
Классификация
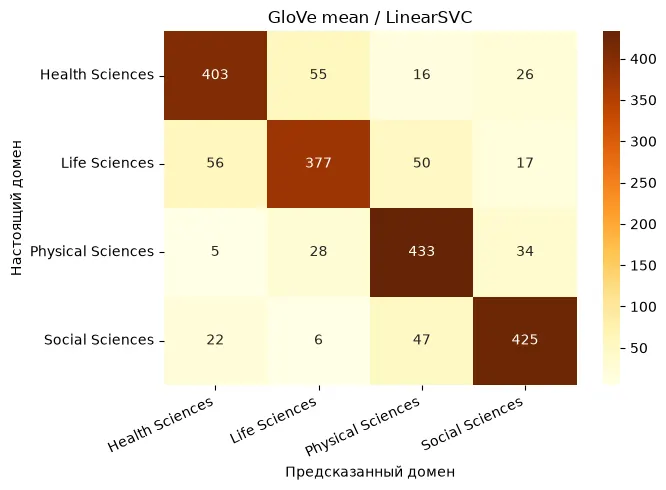
Вектор каждого документа это среднее известных слов. Неизвестные пропускаю; если ни одного известного, возвращаю нули. У среднего есть отрицательные компоненты. Поэтому MultinomialNB здесь неприменим: он требует неотрицательных признаков, интерпретируемых как частоты или веса. LinearSVC принимает оба знака.
Почему GloVe не подаём в MultinomialNB?
MultinomialNB проверяет неотрицательность входа. Простое смещение значений ещё не делает их частотами.
Код и построчный разбор
Код исходной ячейки 56: from sklearn.metrics.pairwise import cosine_similarity
from sklearn.metrics.pairwise import cosine_similarity

def most_similar(word, embeddings, word2ind, top_n=5):
    if word not in word2ind:
        raise KeyError(f'Слово {word} отсутствует в словаре')
    index = word2ind[word]
    scores = cosine_similarity(embeddings[index:index+1], embeddings).ravel()
    scores[index] = -np.inf
    order = np.argsort(-scores, kind='stable')[:min(top_n,len(scores)-1)]
    words = np.array(list(word2ind))
    return [(str(words[i]),float(scores[i])) for i in order]
1: from sklearn.metrics.pairwise import cosine_similarity
Подключает готовые инструменты; import сам по себе модель не обучает.3: def most_similar(word, embeddings, word2ind, top_n=5):
Объявляет функцию: код внутри выполняется при её вызове.4: if word not in word2ind:
Выполняет вложенный блок только при истинном условии.5: raise KeyError(f'Слово {word} отсутствует в словаре')
Сообщает об ошибке и останавливает этот путь выполнения.6: index = word2ind[word]
Вычисляет правую часть и сохраняет результат в index.7: scores = cosine_similarity(embeddings[index:index+1], embeddings).ravel()
Вычисляет сходство направлений векторов.8: scores[index] = -np.inf
Вычисляет правую часть и сохраняет результат в scores[index].9: order = np.argsort(-scores, kind='stable')[:min(top_n,len(scores)-1)]
Возвращает индексы сортировки, чтобы выбрать самые большие оценки.10: words = np.array(list(word2ind))
Вычисляет правую часть и сохраняет результат в words.11: return [(str(words[i]),float(scores[i])) for i in order]
Возвращает результат функции вызывающему коду.
Код исходной ячейки 59: def load_embedding_model():
def load_embedding_model():
    from gensim.models import KeyedVectors
    import gensim.downloader as api
    if (DATA / 'glove.model').exists():
        model = KeyedVectors.load(str(DATA / 'glove.model'), mmap='r')
    else:
        model = api.load('glove-wiki-gigaword-200')
    print('Слов в модели:', len(model), '| размер вектора:', model.vector_size)
    return model

wv_from_bin = load_embedding_model()
1: def load_embedding_model():
Объявляет функцию: код внутри выполняется при её вызове.2: from gensim.models import KeyedVectors
Подключает готовые инструменты; import сам по себе модель не обучает.3: import gensim.downloader as api
Подключает готовые инструменты; import сам по себе модель не обучает.4: if (DATA / 'glove.model').exists():
Выполняет вложенный блок только при истинном условии.5: model = KeyedVectors.load(str(DATA / 'glove.model'), mmap='r')
Вычисляет правую часть и сохраняет результат в model.6: else:
Ветвь для случая, когда предыдущее условие не выполнено.7: model = api.load('glove-wiki-gigaword-200')
Вычисляет правую часть и сохраняет результат в model.8: print('Слов в модели:', len(model), '| размер вектора:', model.vector_size)
Печатает число или пояснение, чтобы проверить результат выполнения.9: return model
Возвращает результат функции вызывающему коду.11: wv_from_bin = load_embedding_model()
Вычисляет правую часть и сохраняет результат в wv_from_bin.
Код исходной ячейки 60: for word in ['algorithm', 'ecology', 'expression', 'gene', 'python', 'treatment']:
for word in ['algorithm', 'ecology', 'expression', 'gene', 'python', 'treatment']:
    print('-'*50,word,sep='\n')
    print(wv_from_bin.most_similar(word,topn=10))
1: for word in ['algorithm', 'ecology', 'expression', 'gene', 'python', 'treatment']:
Повторяет вложенный блок для каждого элемента указанной последовательности.2: print('-'*50,word,sep='\n')
Печатает число или пояснение, чтобы проверить результат выполнения.3: print(wv_from_bin.most_similar(word,topn=10))
Печатает число или пояснение, чтобы проверить результат выполнения.
Код исходной ячейки 62: from pprint import pprint
from pprint import pprint
# 1. Многозначное слово: bank (банк / берег).
pprint(wv_from_bin.most_similar('bank',topn=10))
# 2. Проверяю несколько осмысленных троек; выбираю выполненное неравенство.
triples = [('good','excellent','bad'), ('hot','scorching','cold'), ('happy','joyful','sad'), ('large','enormous','small')]
valid = []
for w1,w2,w3 in triples:
    d_syn = wv_from_bin.distance(w1,w2)
    d_ant = wv_from_bin.distance(w1,w3)
    print(w1,w2,w3,'синоним:',round(float(d_syn),4),'антоним:',round(float(d_ant),4))
    if d_ant < d_syn:
        valid.append((w1,w2,w3))
assert valid, 'Нужно подобрать другую тройку'
print('Подходящие тройки:',valid)
# 3. Ассоциации профессий с направлением gender, не свойства людей.
professions = ['engineer','nurse','doctor','teacher','programmer','secretary']
gender_direction = wv_from_bin['he'] - wv_from_bin['she']
bias = {word: float(cosine_similarity(wv_from_bin[word][None,:],gender_direction[None,:])[0,0]) for word in professions}
print('Косинус профессии с he - she:',bias)
plt.figure(figsize=(8,4));plt.barh(list(bias),list(bias.values()),label='cos(word, he - she)',color='#bb951e')
plt.axvline(0,color='gray');plt.xlabel('Косинус: положительный ближе к направлению he');plt.ylabel('Профессия');plt.title('Ассоциации в обученном GloVe');plt.legend();plt.tight_layout();plt.show()
1: from pprint import pprint
Подключает готовые инструменты; import сам по себе модель не обучает.2: # 1. Многозначное слово: bank (банк / берег).
Комментарий объясняет причину следующего действия.3: pprint(wv_from_bin.most_similar('bank',topn=10))
Печатает число или пояснение, чтобы проверить результат выполнения.4: # 2. Проверяю несколько осмысленных троек; выбираю выполненное неравенство.
Комментарий объясняет причину следующего действия.5: triples = [('good','excellent','bad'), ('hot','scorching','cold'), ('happy','joyful','sad'), ('large','enormous','small')]
Вычисляет правую часть и сохраняет результат в triples.6: valid = []
Вычисляет правую часть и сохраняет результат в valid.7: for w1,w2,w3 in triples:
Повторяет вложенный блок для каждого элемента указанной последовательности.8: d_syn = wv_from_bin.distance(w1,w2)
Вычисляет правую часть и сохраняет результат в d_syn.9: d_ant = wv_from_bin.distance(w1,w3)
Вычисляет правую часть и сохраняет результат в d_ant.10: print(w1,w2,w3,'синоним:',round(float(d_syn),4),'антоним:',round(float(d_ant),4))
Печатает число или пояснение, чтобы проверить результат выполнения.11: if d_ant < d_syn:
Выполняет вложенный блок только при истинном условии.12: valid.append((w1,w2,w3))
Добавляет один результат в список; порядок сохраняется.13: assert valid, 'Нужно подобрать другую тройку'
Проверяет ожидаемое свойство; если оно нарушено, останавливает запуск.14: print('Подходящие тройки:',valid)
Печатает число или пояснение, чтобы проверить результат выполнения.15: # 3. Ассоциации профессий с направлением gender, не свойства людей.
Комментарий объясняет причину следующего действия.16: professions = ['engineer','nurse','doctor','teacher','programmer','secretary']
Вычисляет правую часть и сохраняет результат в professions.17: gender_direction = wv_from_bin['he'] - wv_from_bin['she']
Вычисляет правую часть и сохраняет результат в gender_direction.18: bias = {word: float(cosine_similarity(wv_from_bin[word][None,:],gender_direction[None,:])[0,0]) for word in professions}
Повторяет вложенный блок для каждого элемента указанной последовательности.19: print('Косинус профессии с he - she:',bias)
Печатает число или пояснение, чтобы проверить результат выполнения.20: plt.figure(figsize=(8,4));plt.barh(list(bias),list(bias.values()),label='cos(word, he - she)',color='#bb951e')
Настраивает график, подписи или выводит его на экран.21: plt.axvline(0,color='gray');plt.xlabel('Косинус: положительный ближе к направлению he');plt.ylabel('Профессия');plt.title('Ассоциации в обученном GloVe');plt.legend();plt.tight_layout();plt.show()
Настраивает график, подписи или выводит его на экран.
Код исходной ячейки 64: def mean_embeddings(texts):
def mean_embeddings(texts):
    vectors = np.zeros((len(texts),wv_from_bin.vector_size),dtype=np.float32)
    known,total = 0,0
    for i,text in enumerate(texts):
        tokens=text.split()
        available=[word for word in tokens if word in wv_from_bin]
        known += len(available);total += len(tokens)
        if available:
            vectors[i]=wv_from_bin.get_mean_vector(available)
    print('Покрытие токенов:',round(known/max(total,1),4))
    return vectors
start=perf_counter()
G_train=mean_embeddings(train_text);G_test=mean_embeddings(test_text)
glove_vector_s=perf_counter()-start
model=LinearSVC(random_state=42)
start=perf_counter();model.fit(G_train,y_train);glove_fit_s=perf_counter()-start
pred=model.predict(G_test)
print('GloVe macro-F1:',round(f1_score(y_test,pred,average='macro'),4),'векторизация, с:',round(glove_vector_s,2),'обучение, с:',round(glove_fit_s,2))
print(classification_report(y_test,pred,digits=3,zero_division=0))
print('Минимальная компонента:',float(G_train.min()))
plt.figure(figsize=(7,5));sns.heatmap(confusion_matrix(y_test,pred,labels=labels),annot=True,fmt='d',xticklabels=labels,yticklabels=labels,cmap='YlOrBr')
plt.xlabel('Предсказанный домен');plt.ylabel('Настоящий домен');plt.title('GloVe mean / LinearSVC');plt.xticks(rotation=25,ha='right');plt.yticks(rotation=0);plt.tight_layout();plt.show()
1: def mean_embeddings(texts):
Объявляет функцию: код внутри выполняется при её вызове.2: vectors = np.zeros((len(texts),wv_from_bin.vector_size),dtype=np.float32)
Создаёт массив нулей нужного размера; неизвестные тексты могут остаться нулевыми.3: known,total = 0,0
Вычисляет правую часть и сохраняет результат в known,total.4: for i,text in enumerate(texts):
Повторяет вложенный блок для каждого элемента указанной последовательности.5: tokens=text.split()
Вычисляет правую часть и сохраняет результат в tokens.6: available=[word for word in tokens if word in wv_from_bin]
Повторяет вложенный блок для каждого элемента указанной последовательности.7: known += len(available);total += len(tokens)
Вычисляет правую часть и сохраняет результат в known +.8: if available:
Выполняет вложенный блок только при истинном условии.9: vectors[i]=wv_from_bin.get_mean_vector(available)
Усредняет векторы известных слов документа.10: print('Покрытие токенов:',round(known/max(total,1),4))
Печатает число или пояснение, чтобы проверить результат выполнения.11: return vectors
Возвращает результат функции вызывающему коду.12: start=perf_counter()
Замеряет время, чтобы отдельно оценить затраты на этот этап.13: G_train=mean_embeddings(train_text);G_test=mean_embeddings(test_text)
Вычисляет правую часть и сохраняет результат в G_train.14: glove_vector_s=perf_counter()-start
Замеряет время, чтобы отдельно оценить затраты на этот этап.15: model=LinearSVC(random_state=42)
Вычисляет правую часть и сохраняет результат в model.16: start=perf_counter();model.fit(G_train,y_train);glove_fit_s=perf_counter()-start
Обучает объект по переданным данным; test здесь использовать нельзя.17: pred=model.predict(G_test)
Получает предсказанные домены из обученного классификатора.18: print('GloVe macro-F1:',round(f1_score(y_test,pred,average='macro'),4),'векторизация, с:',round(glove_vector_s,2),'обучение, с:',round(glove_fit_s,2))
Печатает число или пояснение, чтобы проверить результат выполнения.19: print(classification_report(y_test,pred,digits=3,zero_division=0))
Выводит precision, recall, F1 и support отдельно по каждому классу.20: print('Минимальная компонента:',float(G_train.min()))
Печатает число или пояснение, чтобы проверить результат выполнения.21: plt.figure(figsize=(7,5));sns.heatmap(confusion_matrix(y_test,pred,labels=labels),annot=True,fmt='d',xticklabels=labels,yticklabels=labels,cmap='YlOrBr')
Считает таблицу настоящих и предсказанных меток.22: plt.xlabel('Предсказанный домен');plt.ylabel('Настоящий домен');plt.title('GloVe mean / LinearSVC');plt.xticks(rotation=25,ha='right');plt.yticks(rotation=0);plt.tight_layout();plt.show()
Настраивает график, подписи или выводит его на экран.
Проверенные расстояния: large-small ≈ 0.1498, large-enormous ≈ 0.3426. Неравенство действительно выполнено в нашей загруженной модели.
Вопросы защиты
Почему антонимы могут быть близкими?
Они стоят в одинаковых контекстах: good film / bad film. Близость контекстов не равна синонимии.
Как обрабатывается многозначность?
Статический GloVe даёт один вектор на слово и не различает значения по предложению.
Самое похожее слово это само слово?
При поиске соседей его нужно явно исключать.
Почему готовая модель лучше своей маленькой?
Обучалась на гораздо большем корпусе. Но это гипотеза для соседей, а качество классификации надо измерять.