Разобраться с нуля
Контекст: какие слова стоят рядом
В BoW строка это статья. Здесь строка это слово, столбец это его сосед.
- Окно контекста
- Сколько слов слева и справа считаем соседями.
- Совстречаемость
- Число раз, когда пара слов оказалась в одном окне.
- TruncatedSVD
- Готовое разложение, оставляющее k компонент большой разреженной матрицы.
- Эмбеддинг
- Компактный численный вектор слова.
На пальцах. Слово можно узнать по компании. Gene стоит рядом с expression, algorithm рядом с method. Схожие компании дают похожие векторы.
Корпус теста из задания: apple banana apple / orange banana grape.
Числа из теста
Окно 1: apple слева и справа от banana, поэтому M[apple,banana]=2, M[banana,apple]=2. Orange и grape стоят по разные стороны banana и не соседи друг друга. Границу между статьями не пересекаем.
Дальше в ноутбуке
- Считаю матрицу по предобработанному train-корпусу.
- Оставляю 12000 частых слов, не превращая большую матрицу в плотную.
- Применяю log(1+x) к ненулевым счётчикам.
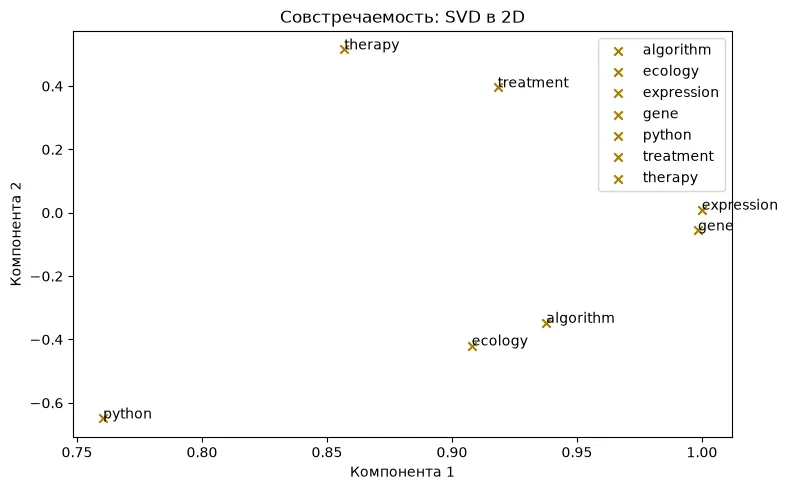
- SVD до 2 координат для рисунка, до 312 для поиска соседей.
- Нормализую строки и сравниваю направления векторов.
Ловушка. Полный GloVe обучает взвешенную функцию потерь с bias. Наш раздел по шаблону использует SVD. Нельзя утверждать, что это точная реализация оригинального GloVe. Двух координат мало для качественного поиска похожих слов.
Код и построчный разбор
Код исходной ячейки 49: from sklearn.decomposition import TruncatedSVD
from sklearn.decomposition import TruncatedSVD
from scipy.sparse import csr_matrix

def get_distinct_words(corpus):
    words = sorted({word for document in corpus for word in document})
    return words, len(words)

def compute_cooccurrence_matrix(corpus, window_size=1):
    words, n_words = get_distinct_words(corpus)
    word2ind = {word: index for index, word in enumerate(words)}
    pairs = Counter()
    for document in corpus:
        indices = [word2ind[word] for word in document]
        for position, center in enumerate(indices):
            for neighbor in indices[max(0,position-window_size):position]:
                pairs[center,neighbor] += 1
                pairs[neighbor,center] += 1
    if not pairs:
        return csr_matrix((n_words,n_words),dtype=float), word2ind
    positions = np.array(list(pairs))
    M = csr_matrix((list(pairs.values()), (positions[:,0],positions[:,1])),shape=(n_words,n_words),dtype=float)
    return M, word2ind

def normalize(M):
    lengths = np.linalg.norm(M, axis=1)
    return M / np.maximum(lengths[:, None], 1e-15)
1: from sklearn.decomposition import TruncatedSVD
Подключает готовые инструменты; import сам по себе модель не обучает.2: from scipy.sparse import csr_matrix
Подключает готовые инструменты; import сам по себе модель не обучает.4: def get_distinct_words(corpus):
Объявляет функцию: код внутри выполняется при её вызове.5: words = sorted({word for document in corpus for word in document})
Повторяет вложенный блок для каждого элемента указанной последовательности.6: return words, len(words)
Возвращает результат функции вызывающему коду.8: def compute_cooccurrence_matrix(corpus, window_size=1):
Объявляет функцию: код внутри выполняется при её вызове.9: words, n_words = get_distinct_words(corpus)
Вычисляет правую часть и сохраняет результат в words, n_words.10: word2ind = {word: index for index, word in enumerate(words)}
Повторяет вложенный блок для каждого элемента указанной последовательности.11: pairs = Counter()
Подсчитывает частоты токенов или пар.12: for document in corpus:
Повторяет вложенный блок для каждого элемента указанной последовательности.13: indices = [word2ind[word] for word in document]
Повторяет вложенный блок для каждого элемента указанной последовательности.14: for position, center in enumerate(indices):
Повторяет вложенный блок для каждого элемента указанной последовательности.15: for neighbor in indices[max(0,position-window_size):position]:
Повторяет вложенный блок для каждого элемента указанной последовательности.16: pairs[center,neighbor] += 1
Вычисляет правую часть и сохраняет результат в pairs[center,neighbor] +.17: pairs[neighbor,center] += 1
Вычисляет правую часть и сохраняет результат в pairs[neighbor,center] +.18: if not pairs:
Выполняет вложенный блок только при истинном условии.19: return csr_matrix((n_words,n_words),dtype=float), word2ind
Возвращает результат функции вызывающему коду.20: positions = np.array(list(pairs))
Вычисляет правую часть и сохраняет результат в positions.21: M = csr_matrix((list(pairs.values()), (positions[:,0],positions[:,1])),shape=(n_words,n_words),dtype=float)
Собирает разреженную матрицу из ненулевых значений и их координат.22: return M, word2ind
Возвращает результат функции вызывающему коду.24: def normalize(M):
Объявляет функцию: код внутри выполняется при её вызове.25: lengths = np.linalg.norm(M, axis=1)
Считает длины векторов для нормализации.26: return M / np.maximum(lengths[:, None], 1e-15)
Возвращает результат функции вызывающему коду.
Код исходной ячейки 50: # Тесты
# Тесты

corpus = [["apple", "banana", "apple"], ["orange", "banana", "grape"]]
distinct_words, num_words = get_distinct_words(corpus)
assert distinct_words == ["apple", "banana", "grape", "orange"]
assert num_words == 4
print("get_distinct_words() works correctly!")

corpus = [["apple", "banana", "apple"], ["orange", "banana", "grape"]]
window_size = 1
M, word2ind = compute_cooccurrence_matrix(corpus, window_size)
expected_indices = {'apple': 0, 'banana': 1, 'grape': 2, 'orange': 3}
expected_matrix = [[0., 2., 0., 0.],
                    [2., 0., 1., 1.],
                    [0., 1., 0., 0.],
                    [0., 1., 0., 0.]]
assert word2ind == expected_indices
assert (M.toarray() == expected_matrix).all()
print("compute_cooccurrence_matrix() works correctly!")
1: # Тесты
Комментарий объясняет причину следующего действия.3: corpus = [["apple", "banana", "apple"], ["orange", "banana", "grape"]]
Вычисляет правую часть и сохраняет результат в corpus.4: distinct_words, num_words = get_distinct_words(corpus)
Вычисляет правую часть и сохраняет результат в distinct_words, num_words.5: assert distinct_words == ["apple", "banana", "grape", "orange"]
Проверяет ожидаемое свойство; если оно нарушено, останавливает запуск.6: assert num_words == 4
Проверяет ожидаемое свойство; если оно нарушено, останавливает запуск.7: print("get_distinct_words() works correctly!")
Печатает число или пояснение, чтобы проверить результат выполнения.9: corpus = [["apple", "banana", "apple"], ["orange", "banana", "grape"]]
Вычисляет правую часть и сохраняет результат в corpus.10: window_size = 1
Вычисляет правую часть и сохраняет результат в window_size.11: M, word2ind = compute_cooccurrence_matrix(corpus, window_size)
Вычисляет правую часть и сохраняет результат в M, word2ind.12: expected_indices = {'apple': 0, 'banana': 1, 'grape': 2, 'orange': 3}
Вычисляет правую часть и сохраняет результат в expected_indices.13: expected_matrix = [[0., 2., 0., 0.],
Вычисляет правую часть и сохраняет результат в expected_matrix.14: [2., 0., 1., 1.],
Продолжает выражение предыдущей строки: здесь заданы данные или аргументы вызова.15: [0., 1., 0., 0.],
Продолжает выражение предыдущей строки: здесь заданы данные или аргументы вызова.16: [0., 1., 0., 0.]]
Продолжает выражение предыдущей строки: здесь заданы данные или аргументы вызова.17: assert word2ind == expected_indices
Проверяет ожидаемое свойство; если оно нарушено, останавливает запуск.18: assert (M.toarray() == expected_matrix).all()
Проверяет ожидаемое свойство; если оно нарушено, останавливает запуск.19: print("compute_cooccurrence_matrix() works correctly!")
Печатает число или пояснение, чтобы проверить результат выполнения.
Код исходной ячейки 52: # Для своего корпуса строю матрицу сам: скачивать pickle не нужно.
# Для своего корпуса строю матрицу сам: скачивать pickle не нужно.
# Ограничение словаря уменьшает память и время разложения.
context_vocab = CountVectorizer(max_features=12000, min_df=3).fit(train_text).vocabulary_
corpus = [text.split() for text in train_text]
M_full, full_word2ind = compute_cooccurrence_matrix(corpus, window_size=2)
selected_words = sorted(context_vocab)
selected_indices = [full_word2ind[word] for word in selected_words]
M = M_full[selected_indices][:, selected_indices]
word2ind = {word: index for index,word in enumerate(selected_words)}
del M_full
print('Матрица:', M.shape, '| ненулевых:', M.nnz, '| память, МБ:', round((M.data.nbytes+M.indices.nbytes+M.indptr.nbytes)/1e6,2))
1: # Для своего корпуса строю матрицу сам: скачивать pickle не нужно.
Комментарий объясняет причину следующего действия.2: # Ограничение словаря уменьшает память и время разложения.
Комментарий объясняет причину следующего действия.3: context_vocab = CountVectorizer(max_features=12000, min_df=3).fit(train_text).vocabulary_
Обучает объект по переданным данным; test здесь использовать нельзя.4: corpus = [text.split() for text in train_text]
Повторяет вложенный блок для каждого элемента указанной последовательности.5: M_full, full_word2ind = compute_cooccurrence_matrix(corpus, window_size=2)
Вычисляет правую часть и сохраняет результат в M_full, full_word2ind.6: selected_words = sorted(context_vocab)
Сортирует значения, чтобы порядок слов и столбцов был воспроизводимым.7: selected_indices = [full_word2ind[word] for word in selected_words]
Повторяет вложенный блок для каждого элемента указанной последовательности.8: M = M_full[selected_indices][:, selected_indices]
Вычисляет правую часть и сохраняет результат в M.9: word2ind = {word: index for index,word in enumerate(selected_words)}
Повторяет вложенный блок для каждого элемента указанной последовательности.10: del M_full
Управляет ресурсом: открытым архивом или больше не нужной матрицей.11: print('Матрица:', M.shape, '| ненулевых:', M.nnz, '| память, МБ:', round((M.data.nbytes+M.indices.nbytes+M.indptr.nbytes)/1e6,2))
Печатает число или пояснение, чтобы проверить результат выполнения.
Код исходной ячейки 53: # log(1+x) уменьшает влияние очень частых пар.
# log(1+x) уменьшает влияние очень частых пар.
log_M = M.copy()
log_M.data = np.log1p(log_M.data)
M_reduced = TruncatedSVD(n_components=2, random_state=42).fit_transform(log_M)
embeddings = normalize(M_reduced)
plt.figure(figsize=(8,5))
for word in ['algorithm', 'ecology', 'expression', 'gene', 'python', 'treatment', 'therapy']:
    if word in word2ind:
        x,y = embeddings[word2ind[word]]
        plt.scatter(x,y,marker='x',color='#a77d00',label=word)
        plt.annotate(word,(x,y))
plt.xlabel('Компонента 1');plt.ylabel('Компонента 2');plt.title('Совстречаемость: SVD в 2D');plt.legend()
plt.tight_layout();plt.show()
1: # log(1+x) уменьшает влияние очень частых пар.
Комментарий объясняет причину следующего действия.2: log_M = M.copy()
Вычисляет правую часть и сохраняет результат в log_M.3: log_M.data = np.log1p(log_M.data)
Считает log(1+x), уменьшая влияние очень частых пар слов.4: M_reduced = TruncatedSVD(n_components=2, random_state=42).fit_transform(log_M)
Выучивает словарь и статистику по обучающим текстам и сразу строит их матрицу.5: embeddings = normalize(M_reduced)
Вычисляет правую часть и сохраняет результат в embeddings.6: plt.figure(figsize=(8,5))
Настраивает график, подписи или выводит его на экран.7: for word in ['algorithm', 'ecology', 'expression', 'gene', 'python', 'treatment', 'therapy']:
Повторяет вложенный блок для каждого элемента указанной последовательности.8: if word in word2ind:
Выполняет вложенный блок только при истинном условии.9: x,y = embeddings[word2ind[word]]
Вычисляет правую часть и сохраняет результат в x,y.10: plt.scatter(x,y,marker='x',color='#a77d00',label=word)
Настраивает график, подписи или выводит его на экран.11: plt.annotate(word,(x,y))
Настраивает график, подписи или выводит его на экран.12: plt.xlabel('Компонента 1');plt.ylabel('Компонента 2');plt.title('Совстречаемость: SVD в 2D');plt.legend()
Настраивает график, подписи или выводит его на экран.13: plt.tight_layout();plt.show()
Настраивает график, подписи или выводит его на экран.
Код исходной ячейки 54: len(word2ind) # vocabulary size
len(word2ind) # vocabulary size1: len(word2ind) # vocabulary size
Продолжает выражение предыдущей строки: здесь заданы данные или аргументы вызова.
Код исходной ячейки 57: M_reduced = TruncatedSVD(n_components=312, random_state=42).fit_transform(log_M)
M_reduced = TruncatedSVD(n_components=312, random_state=42).fit_transform(log_M)
embeddings = normalize(M_reduced)
for word in ['algorithm', 'ecology', 'expression', 'gene', 'python', 'treatment']:
    print('-'*50, word, sep='\n')
    print(most_similar(word, embeddings, word2ind, top_n=10) if word in word2ind else 'Нет в словаре 12000 слов')
# Проверки MSE восстановления и исключения самого слова из соседей.
assert np.mean((U@V_T-A)**2) < 1e-3
assert np.mean((U2_long@VT2_long-A2)**2) < 1e-3
for word in list(word2ind)[:3]:
    assert all(other != word for other,score in most_similar(word, embeddings, word2ind))
1: M_reduced = TruncatedSVD(n_components=312, random_state=42).fit_transform(log_M)
Выучивает словарь и статистику по обучающим текстам и сразу строит их матрицу.2: embeddings = normalize(M_reduced)
Вычисляет правую часть и сохраняет результат в embeddings.3: for word in ['algorithm', 'ecology', 'expression', 'gene', 'python', 'treatment']:
Повторяет вложенный блок для каждого элемента указанной последовательности.4: print('-'*50, word, sep='\n')
Печатает число или пояснение, чтобы проверить результат выполнения.5: print(most_similar(word, embeddings, word2ind, top_n=10) if word in word2ind else 'Нет в словаре 12000 слов')
Выполняет вложенный блок только при истинном условии.6: # Проверки MSE восстановления и исключения самого слова из соседей.
Комментарий объясняет причину следующего действия.7: assert np.mean((U@V_T-A)**2) < 1e-3
Проверяет ожидаемое свойство; если оно нарушено, останавливает запуск.8: assert np.mean((U2_long@VT2_long-A2)**2) < 1e-3
Проверяет ожидаемое свойство; если оно нарушено, останавливает запуск.9: for word in list(word2ind)[:3]:
Повторяет вложенный блок для каждого элемента указанной последовательности.10: assert all(other != word for other,score in most_similar(word, embeddings, word2ind))
Повторяет вложенный блок для каждого элемента указанной последовательности.
Вопросы защиты
Почему матрица симметричная?
Учитываем левых и правых соседей. Каждой паре добавляем оба направления.
Зачем log(1+x)?
Снижает доминирование очень частых пар и корректно обрабатывает нулевые значения.
Что не так с удалением стоп-слов перед окном?
Соседство определяется уже в очищенном тексте. Это не совсем то же окно, что в исходной статье.
Почему считаем только train?
Чтобы статистика отложенных статей не влияла на наши векторы.
Одна фразаСчитаю соседство слов в разреженной матрице и сжимаю его до компактных координат.