Данные · 3 балла вместе с очисткой
Данные и честная проверка
10 000 статей, четыре домена, 8000 примеров для обучения и 2000 для экзамена.
- Запись
- Одна статья, строка таблицы.
- id
- Уникальный адрес статьи в OpenAlex.
- title / abstract
- Заголовок и аннотация.
- domain
- Целевая метка: нужная полка.
- API
- Адрес, куда программа посылает запрос и получает данные.
- Пагинация
- Получение длинного списка частями, страницами.
- Обратный индекс
- Слово → список его позиций в тексте.
- Train / test
- Учебник / закрытый экзамен.
- Утечка
- Информация из экзамена попала в обучение.
- stratify
- Сохранение долей классов при разбиении.
Что именно собрано
По 2500 англоязычных статей с заполненными четырьмя полями. Точные дубликаты текста и id исключены. Это первые подходящие страницы API, а не случайная выборка всех статей. Такой выбор ускоряет сбор, но ограничивает обобщение результатов.
Ноутбук скачивает отдельный сжатый снимок данных: запуск в Colab восстанавливает ту же выборку без ключа API. Код реального сбора тоже есть. Функция collect_openalex() нужна только для нового сбора; при нём метрики могут измениться.
Что можно до разделения
Привести одно предложение к нижнему регистру можно: соседние статьи не нужны. Узнать, какие слова самые частые во всём корпусе, нельзя: это уже статистика других статей. Поэтому split раньше fit векторизатора.
Выбери действие:
Нажми действие и узнай, есть ли утечка.
Код и построчный разбор
Код исходной ячейки 6: import requests
import requests
from time import sleep, perf_counter
from pathlib import Path
import json, re, gzip, hashlib
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
from IPython.display import display

DATA = Path('data')
DATA.mkdir(exist_ok=True)
# Тот же снимок API скачивается отдельно, чтобы не перегружать редактор Colab.
data_file = DATA / 'openalex.json'
expected_sha256 = 'e37e7acca5c2d92166d9e29ddb2104aee2a84360a2ed3ccd4dff9218dce27cc8'
if not data_file.exists():
    url = 'https://lr4-ml-guide.pages.dev/data/openalex_e37e7acca5c2.bin'
    response = requests.get(url, timeout=180)
    response.raise_for_status()
    raw_data = gzip.decompress(response.content)
    if hashlib.sha256(raw_data).hexdigest() != expected_sha256:
        raise ValueError('Контрольная сумма снимка не совпала')
    data_file.write_bytes(raw_data)
print('Снимок данных готов')
df = pd.read_json(DATA / 'openalex.json')

# Код сбора, использованный для снимка. Для обновления: collect_openalex().
def collect_openalex(per_domain=2500):
    records, seen = [], set()
    for domain_id in range(1, 5):
        count = 0
        for page in range(1, 101):
            params = {'filter': f'language:en,has_abstract:true,primary_topic.domain.id:{domain_id},type:article',
                      'per-page': 100, 'page': page,
                      'select': 'id,title,abstract_inverted_index,primary_topic,language'}
            for attempt in range(6):
                response = requests.get('https://api.openalex.org/works', params=params, timeout=90)
                if response.status_code in (429, 500, 502, 503):
                    sleep(2 ** attempt)
                    continue
                response.raise_for_status()
                break
            response.raise_for_status()
            works = response.json()['results']
            if not works:
                break
            for work in works:
                inverted = work.get('abstract_inverted_index')
                title = work.get('title')
                domain = (work.get('primary_topic') or {}).get('domain')
                if not inverted or not title or not domain or work['id'] in seen:
                    continue
                positions = {p: word for word, indices in inverted.items() for p in indices}
                abstract = ' '.join(positions[p] for p in sorted(positions))
                letters = sum(char.isalpha() for char in title + abstract)
                latin = sum(char.isascii() and char.isalpha() for char in title + abstract)
                if latin / max(letters, 1) <= 0.8:
                    continue
                key = ' '.join((title + ' ' + abstract).lower().split())
                if key in seen:
                    continue
                seen.update([work['id'], key])
                records.append(dict(id=work['id'], title=title, abstract=abstract, domain=domain['display_name']))
                count += 1
                if count == per_domain:
                    break
            if count == per_domain:
                break
            sleep(0.15)
        if count < per_domain:
            raise ValueError(f'Недостаточно записей для домена {domain_id}: {count}')
    result = pd.DataFrame(records)
    result.to_json(DATA / 'openalex.json', orient='records', force_ascii=False)
    return result

assert len(df) >= 10000 and df['id'].is_unique
assert df[['id', 'title', 'abstract', 'domain']].notna().all().all()
df.head()
1: import requests
Подключает готовые инструменты; import сам по себе модель не обучает.2: from time import sleep, perf_counter
Подключает готовые инструменты; import сам по себе модель не обучает.3: from pathlib import Path
Подключает готовые инструменты; import сам по себе модель не обучает.4: import json, re, gzip, hashlib
Подключает готовые инструменты; import сам по себе модель не обучает.5: import numpy as np
Подключает готовые инструменты; import сам по себе модель не обучает.6: import pandas as pd
Подключает готовые инструменты; import сам по себе модель не обучает.7: import matplotlib.pyplot as plt
Подключает готовые инструменты; import сам по себе модель не обучает.8: import seaborn as sns
Подключает готовые инструменты; import сам по себе модель не обучает.9: from IPython.display import display
Подключает готовые инструменты; import сам по себе модель не обучает.11: DATA = Path('data')
Вычисляет правую часть и сохраняет результат в DATA.12: DATA.mkdir(exist_ok=True)
Вычисляет правую часть и сохраняет результат в DATA.mkdir(exist_ok.13: # Тот же снимок API скачивается отдельно, чтобы не перегружать редактор Colab.
Комментарий объясняет причину следующего действия.14: data_file = DATA / 'openalex.json'
Вычисляет правую часть и сохраняет результат в data_file.15: expected_sha256 = 'e37e7acca5c2d92166d9e29ddb2104aee2a84360a2ed3ccd4dff9218dce27cc8'
Вычисляет правую часть и сохраняет результат в expected_sha256.16: if not data_file.exists():
Выполняет вложенный блок только при истинном условии.17: url = 'https://lr4-ml-guide.pages.dev/data/openalex_e37e7acca5c2.bin'
Вычисляет правую часть и сохраняет результат в url.18: response = requests.get(url, timeout=180)
Посылает HTTP-запрос к API или скачивает официальный словарь.19: response.raise_for_status()
Проверяет код ответа сервера и не даёт продолжать с неудачной загрузкой.20: raw_data = gzip.decompress(response.content)
Вычисляет правую часть и сохраняет результат в raw_data.21: if hashlib.sha256(raw_data).hexdigest() != expected_sha256:
Выполняет вложенный блок только при истинном условии.22: raise ValueError('Контрольная сумма снимка не совпала')
Сообщает об ошибке и останавливает этот путь выполнения.23: data_file.write_bytes(raw_data)
Продолжает выражение предыдущей строки: здесь заданы данные или аргументы вызова.24: print('Снимок данных готов')
Печатает число или пояснение, чтобы проверить результат выполнения.25: df = pd.read_json(DATA / 'openalex.json')
Вычисляет правую часть и сохраняет результат в df.27: # Код сбора, использованный для снимка. Для обновления: collect_openalex().
Комментарий объясняет причину следующего действия.28: def collect_openalex(per_domain=2500):
Объявляет функцию: код внутри выполняется при её вызове.29: records, seen = [], set()
Вычисляет правую часть и сохраняет результат в records, seen.30: for domain_id in range(1, 5):
Повторяет вложенный блок для каждого элемента указанной последовательности.31: count = 0
Вычисляет правую часть и сохраняет результат в count.32: for page in range(1, 101):
Повторяет вложенный блок для каждого элемента указанной последовательности.33: params = {'filter': f'language:en,has_abstract:true,primary_topic.domain.id:{domain_id},type:article',
Вычисляет правую часть и сохраняет результат в params.34: 'per-page': 100, 'page': page,
Продолжает выражение предыдущей строки: здесь заданы данные или аргументы вызова.35: 'select': 'id,title,abstract_inverted_index,primary_topic,language'}
Продолжает выражение предыдущей строки: здесь заданы данные или аргументы вызова.36: for attempt in range(6):
Повторяет вложенный блок для каждого элемента указанной последовательности.37: response = requests.get('https://api.openalex.org/works', params=params, timeout=90)
Посылает HTTP-запрос к API или скачивает официальный словарь.38: if response.status_code in (429, 500, 502, 503):
Выполняет вложенный блок только при истинном условии.39: sleep(2 ** attempt)
Продолжает выражение предыдущей строки: здесь заданы данные или аргументы вызова.40: continue
Переходит к следующему элементу цикла, пропустив оставшийся блок.41: response.raise_for_status()
Проверяет код ответа сервера и не даёт продолжать с неудачной загрузкой.42: break
Завершает ближайший цикл, например после получения 2500 записей.43: response.raise_for_status()
Проверяет код ответа сервера и не даёт продолжать с неудачной загрузкой.44: works = response.json()['results']
Вычисляет правую часть и сохраняет результат в works.45: if not works:
Выполняет вложенный блок только при истинном условии.46: break
Завершает ближайший цикл, например после получения 2500 записей.47: for work in works:
Повторяет вложенный блок для каждого элемента указанной последовательности.48: inverted = work.get('abstract_inverted_index')
Вычисляет правую часть и сохраняет результат в inverted.49: title = work.get('title')
Вычисляет правую часть и сохраняет результат в title.50: domain = (work.get('primary_topic') or {}).get('domain')
Вычисляет правую часть и сохраняет результат в domain.51: if not inverted or not title or not domain or work['id'] in seen:
Выполняет вложенный блок только при истинном условии.52: continue
Переходит к следующему элементу цикла, пропустив оставшийся блок.53: positions = {p: word for word, indices in inverted.items() for p in indices}
Повторяет вложенный блок для каждого элемента указанной последовательности.54: abstract = ' '.join(positions[p] for p in sorted(positions))
Повторяет вложенный блок для каждого элемента указанной последовательности.55: letters = sum(char.isalpha() for char in title + abstract)
Повторяет вложенный блок для каждого элемента указанной последовательности.56: latin = sum(char.isascii() and char.isalpha() for char in title + abstract)
Повторяет вложенный блок для каждого элемента указанной последовательности.57: if latin / max(letters, 1) <= 0.8:
Выполняет вложенный блок только при истинном условии.58: continue
Переходит к следующему элементу цикла, пропустив оставшийся блок.59: key = ' '.join((title + ' ' + abstract).lower().split())
Вычисляет правую часть и сохраняет результат в key.60: if key in seen:
Выполняет вложенный блок только при истинном условии.61: continue
Переходит к следующему элементу цикла, пропустив оставшийся блок.62: seen.update([work['id'], key])
Продолжает выражение предыдущей строки: здесь заданы данные или аргументы вызова.63: records.append(dict(id=work['id'], title=title, abstract=abstract, domain=domain['display_name']))
Добавляет один результат в список; порядок сохраняется.64: count += 1
Вычисляет правую часть и сохраняет результат в count +.65: if count == per_domain:
Выполняет вложенный блок только при истинном условии.66: break
Завершает ближайший цикл, например после получения 2500 записей.67: if count == per_domain:
Выполняет вложенный блок только при истинном условии.68: break
Завершает ближайший цикл, например после получения 2500 записей.69: sleep(0.15)
Продолжает выражение предыдущей строки: здесь заданы данные или аргументы вызова.70: if count < per_domain:
Выполняет вложенный блок только при истинном условии.71: raise ValueError(f'Недостаточно записей для домена {domain_id}: {count}')
Сообщает об ошибке и останавливает этот путь выполнения.72: result = pd.DataFrame(records)
Вычисляет правую часть и сохраняет результат в result.73: result.to_json(DATA / 'openalex.json', orient='records', force_ascii=False)
Вычисляет правую часть и сохраняет результат в result.to_json(DATA / 'openalex.json', orient.74: return result
Возвращает результат функции вызывающему коду.76: assert len(df) >= 10000 and df['id'].is_unique
Проверяет ожидаемое свойство; если оно нарушено, останавливает запуск.77: assert df[['id', 'title', 'abstract', 'domain']].notna().all().all()
Проверяет ожидаемое свойство; если оно нарушено, останавливает запуск.78: df.head()
Продолжает выражение предыдущей строки: здесь заданы данные или аргументы вызова.
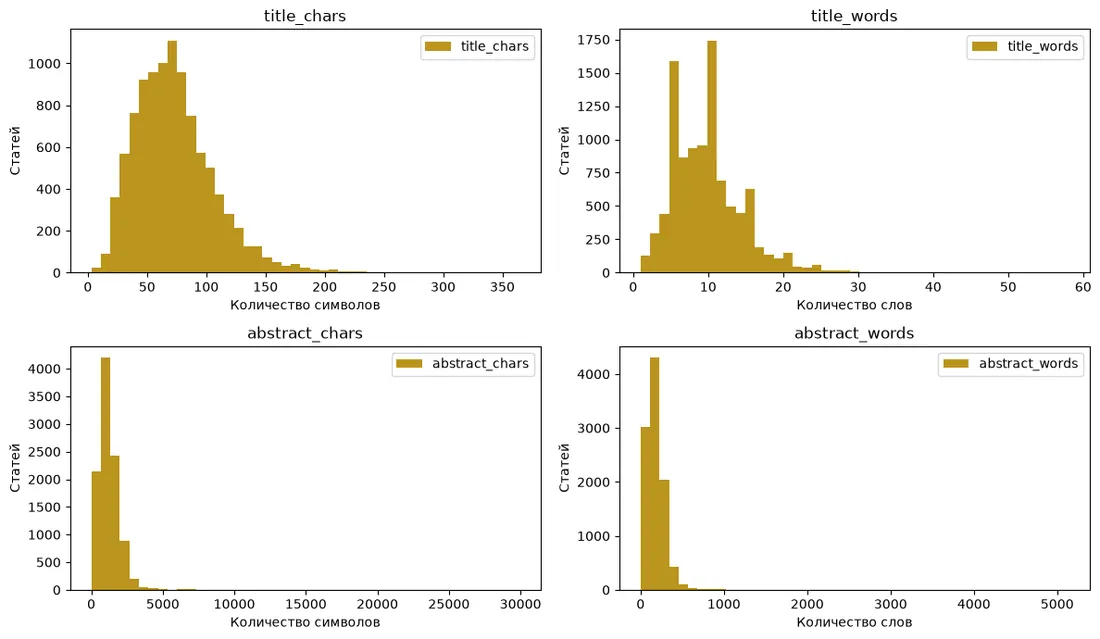
Код исходной ячейки 8: print('Всего записей:', len(df))
print('Всего записей:', len(df))
print('Уникальных доменов:', df['domain'].nunique())
print(df['domain'].value_counts().sort_index())
lengths = pd.DataFrame({f'{field}_{unit}': df[field].str.len() if unit == 'chars' else df[field].str.split().str.len()
                        for field in ['title', 'abstract'] for unit in ['chars', 'words']})
display(lengths.describe().round(1))
fig, axes = plt.subplots(2, 2, figsize=(12, 7))
for ax, column in zip(axes.ravel(), lengths):
    ax.hist(lengths[column], bins=45, label=column, color='#bb951e')
    ax.set(xlabel='Количество символов' if column.endswith('chars') else 'Количество слов', ylabel='Статей', title=column)
    ax.legend()
plt.tight_layout()
plt.show()
1: print('Всего записей:', len(df))
Печатает число или пояснение, чтобы проверить результат выполнения.2: print('Уникальных доменов:', df['domain'].nunique())
Печатает число или пояснение, чтобы проверить результат выполнения.3: print(df['domain'].value_counts().sort_index())
Печатает число или пояснение, чтобы проверить результат выполнения.4: lengths = pd.DataFrame({f'{field}_{unit}': df[field].str.len() if unit == 'chars' else df[field].str.split().str.len()
Выполняет вложенный блок только при истинном условии.5: for field in ['title', 'abstract'] for unit in ['chars', 'words']})
Повторяет вложенный блок для каждого элемента указанной последовательности.6: display(lengths.describe().round(1))
Показывает таблицу в ноутбуке.7: fig, axes = plt.subplots(2, 2, figsize=(12, 7))
Настраивает график, подписи или выводит его на экран.8: for ax, column in zip(axes.ravel(), lengths):
Повторяет вложенный блок для каждого элемента указанной последовательности.9: ax.hist(lengths[column], bins=45, label=column, color='#bb951e')
Настраивает отдельную область общего рисунка.10: ax.set(xlabel='Количество символов' if column.endswith('chars') else 'Количество слов', ylabel='Статей', title=column)
Выполняет вложенный блок только при истинном условии.11: ax.legend()
Настраивает отдельную область общего рисунка.12: plt.tight_layout()
Настраивает график, подписи или выводит его на экран.13: plt.show()
Настраивает график, подписи или выводит его на экран.
Вопросы защиты
Почему не cursor?
Для каждого домена меньше 10 000 результатов, достаточно обычных страниц. У cursor после первой страницы сейчас требуется ключ.
Зачем random_state=42?
Чтобы случайное разбиение повторялось при каждом запуске.
Почему снимок важен?
OpenAlex обновляется. Без снимка изменятся статьи, метки, словарь и метрики.
Что если статья из двух областей?
Берём домен primary_topic, одну основную метку. Междисциплинарность усложняет задачу.